企业引入OpenAI时必须掌握的数据安全与泄露防护指南
 AI 生成图片
要点总结
要在引入OpenAI时防止机密泄露,最好选择适用不用于模型训练政策的Enterprise或API方案。此外,还需要结合提示词网关、DLP脱敏、RBAC权限控制等4步技术防护措施,并制定明确的企业内部指南,才能确保安全。
为了提高工作效率,引入OpenAI的ChatGPT或API的企业正在迅速增加。然而,源代码、客户信息、商业机密等重要资产通过AI输入框泄露到外部的风险也随之增加。据安全行业调查显示,全球企业员工中约有6.5%的人曾在工作中使用生成式AI服务输入过公司内部数据,其中输入机密信息或源代码等敏感数据的比例也达到了3.1%。
如果不建立技术防线和制度指南,极易导致意想不到的信息泄露事故。本文将梳理截至2026年9月OpenAI各订阅方案的数据安全政策差异,并详细讲解安全团队可直接应用于现场的4步防护体系。
企业在引入OpenAI时面临的3大核心数据泄露威胁是什么?
在引入生成式AI的过程中,产生的信息泄露威胁大致可以归纳为三种:员工无意中输入敏感信息、因方案设置不当导致数据被用于模型再训练,以及提示词注入(Prompt Injection)等外部网络攻击。如果未能提前明确认知这些威胁的性质,将直接导致严重的资产损失和违反法律法规。
- 员工无意中输入机密(影子AI现象): 例如开发者在修复Bug时直接将公司核心源代码复制粘贴到ChatGPT中,或策划人员输入未公开的会议纪要和包含个人信息的客户名单。在未经公司批准使用个人账号操作AI的“影子AI(Shadow AI)”情况下,内部管控实际上将变得不可能。
- 输入数据被复用于AI模型训练: 如果按默认设置使用个人免费版或Plus方案,用户输入的提示词和附件可能会被用于AI模型的再训练。这可能会导致日后其他公司的员工向ChatGPT提问时,我们公司的机密信息作为回答被直接泄露。
- 提示词注入及OWASP LLM安全威胁: 在OWASP(开放式Web应用程序安全项目)整理的LLM十大安全风险中,恶意提示词操纵(LLM01)和敏感信息泄露(LLM02)高居首位。存在外部恶意数据进入AI系统内部并撬开内网数据外泄通道的风险。
OpenAI각服务方案的数据安全与训练政策对比如何?
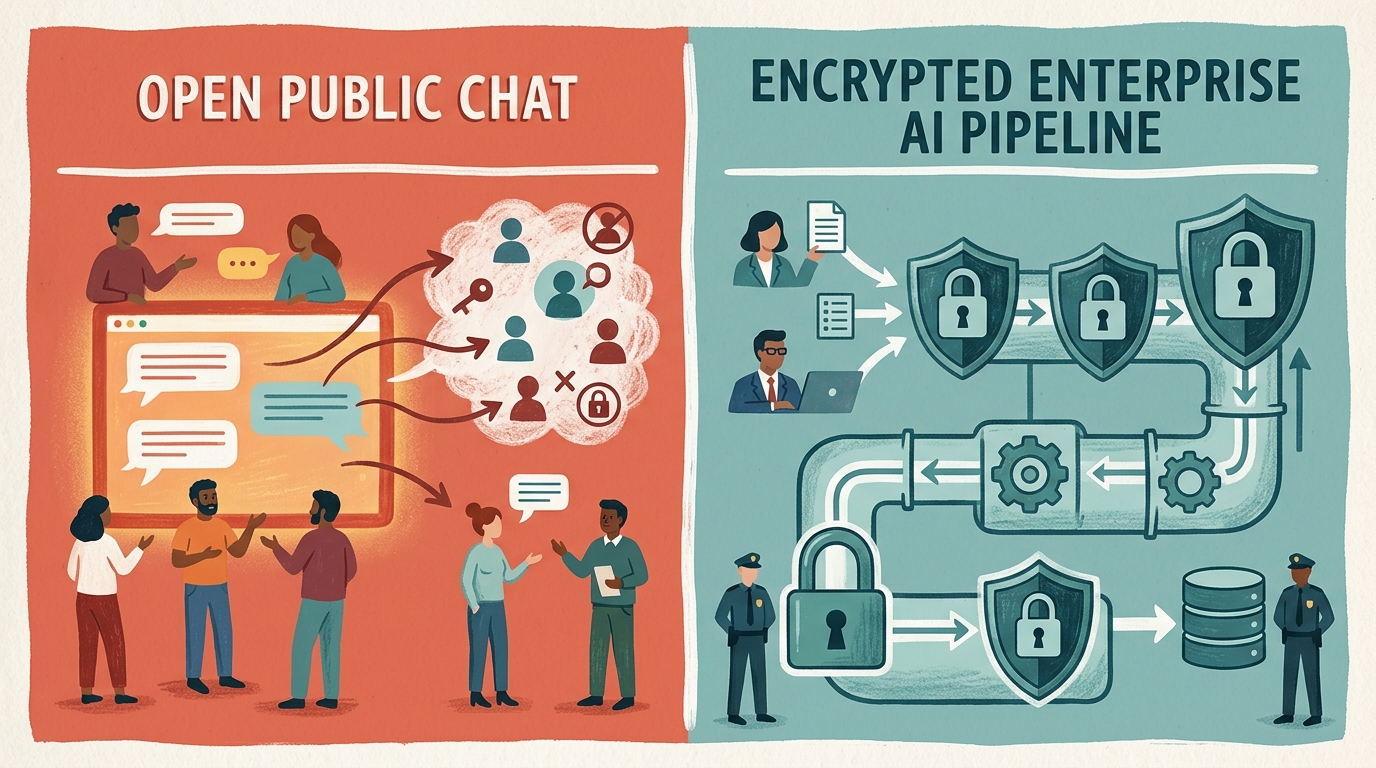
个人用的Free/Plus方案如果不手动关闭退出(Opt-Out)设置,输入的数据就会反映在模型训练中。相比之下,ChatGPT Team、Enterprise方案以及OpenAI API服务在默认设置下不会将输入数据用于模型训练。只有彻底区分各方案的安全标准和加密级别,才能选择符合公司目的且安心的环境。
截至2026年9月,主要方案的数据保护政策汇总如下表所示:
| 方案类别 | 默认数据训练与否 | 数据加密标准 | 主要安全与合规认证 | 推荐适用对象 |
|---|---|---|---|---|
| ChatGPT Free / Plus | 用于训练(默认 Opt-In) | TLS 1.2+, AES-256 | 基础数据安全 | 个人用户及单独测试 |
| ChatGPT Team | 不用于训练(默认 Opt-Out) | TLS 1.2+, AES-256 | 支持 SOC 2 Type 2 | 小型团队及部门单位 |
| ChatGPT Enterprise | 不用于训练(默认 Opt-Out) | TLS 1.2+, AES-256 (静态) | SOC 2 Type 2, SSO, 域名验证 | 大型企业及安全敏感型企业 |
| OpenAI API | 不用于训练(默认 Opt-Out) | TLS 1.2+, AES-256 | SOC 2 Type 2, HIPAA(按需) | 自主开发内部AI应用的企业 |
根据OpenAI官方安全与隐私指南中载明的内容,企业级Enterprise方案和通过API传输的数据在存储时采用AES-256加密,在传输时采用TLS 1.2或更高版本加密。具体的企业安全架构也可以在Dfinite企业AI安全报告中进行详细了解。
 AI 生成图片
彻底杜绝OpenAI数据泄露的4步技术防护体系是什么?
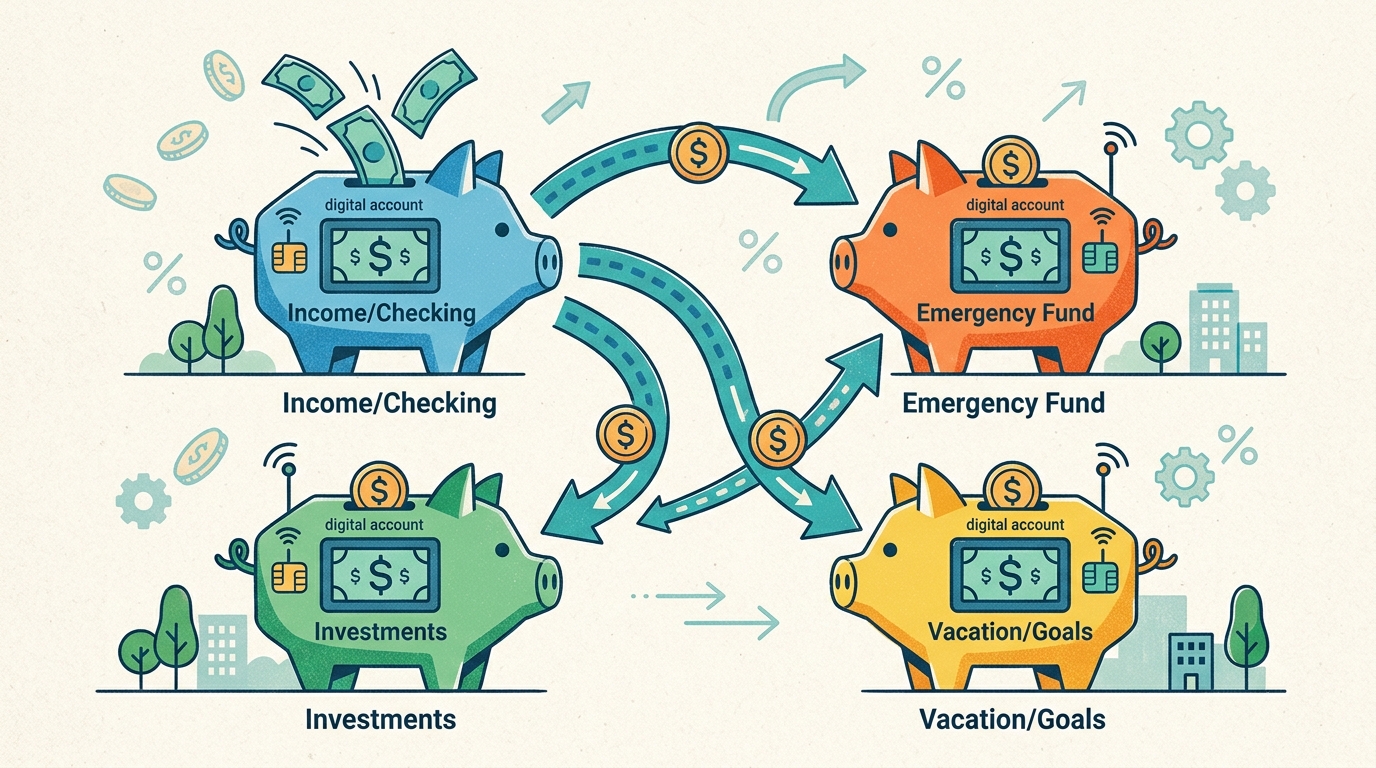
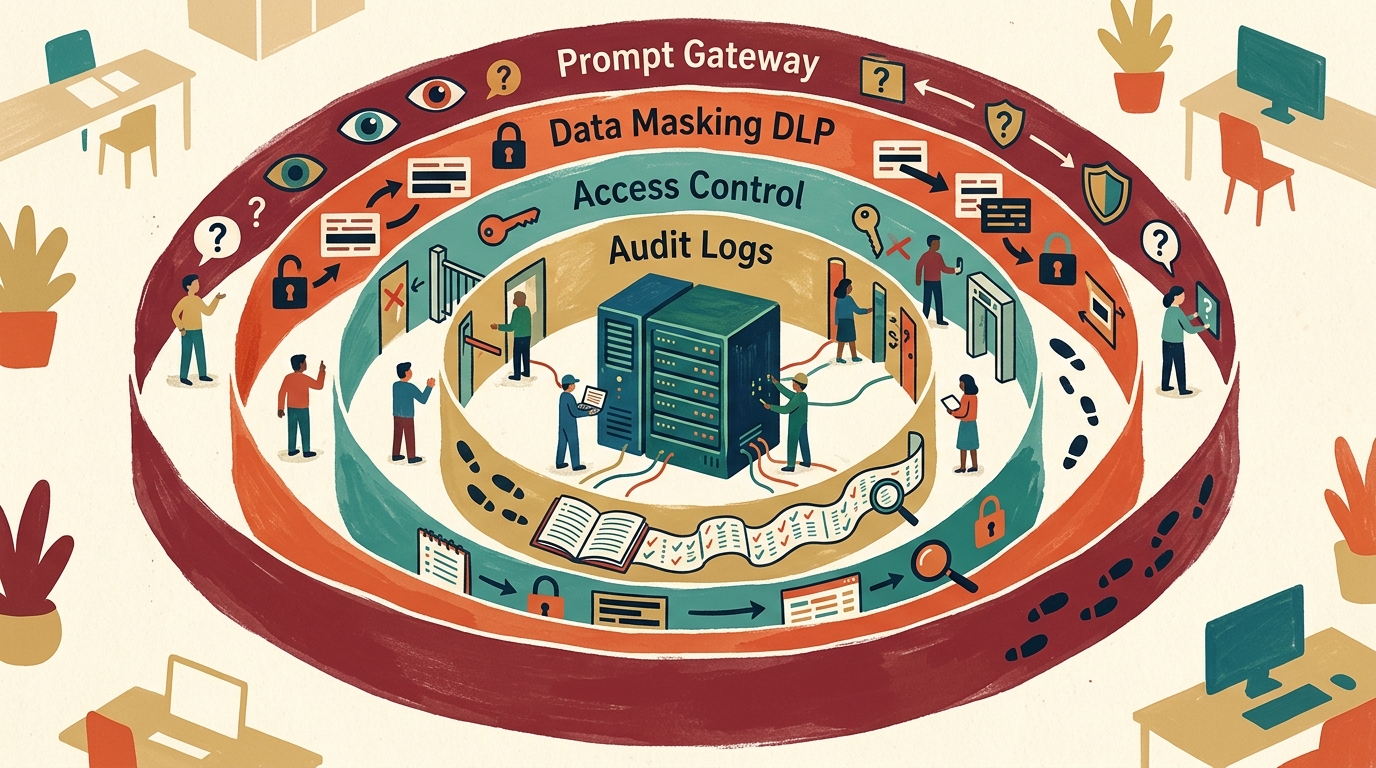
技术防护网可分为4个步骤进行设计:构建企业内部提示词网关、实时数据脱敏(DLP)、API访问权限控制、实时监控与审计日志管理。只有从用户输入提示词的时刻起直至传输到AI服务器的全过程都布设安全装置,才能确保安全。
- 第1步:搭建企业内部提示词网关与CASB 限制员工直接访问外部ChatGPT网站的通道,改用企业内部代理或CASB(云访问安全代理)。关闭未授权个人账号的访问,仅保留已完成SSO认证的企业内部通道。
- 第2步:数据脱敏与实时DLP(数据防泄露)应用 在提示词传输至AI服务器前的瞬间,自动检测身份证号、电话号码、电子邮件、API密钥以及特定源代码模式,并将其脱敏替换为随机字符串。该技术方案可参考Comtrue Technology AI安全技术分析中的介绍。
- 第3步:基于RBAC的API密钥及细粒度权限控制 按部门或开发团队分别发放专用API密钥,并赋予最小权限原则(RBAC)。为了减少密钥泄露造成的损失,必须设置定期轮换(Rotation)周期。
- 第4步:防御提示词注入与SIEM联动监控 部署用于预先过滤输入提示词中恶意指令操作的过滤器,并将所有提示词及回答记录与企业内部SIEM(安全信息和事件管理)监控网联动保存。具体的防御路线图可参考AhnLab企业安全中心指南。
制定企业内部生成式AI使用指南的制度性安全规范是什么?
要建立切实有效的制度性规范,必须将可输入数据类型的定义、强制使用经批准的企业专属账号以及定期开展员工安全培训像齿轮一样紧密结合起来。如果规定模糊不清或一味严苛,就会引发员工偷用个人账号操作AI等副作用。
- 可输入数据级别分类: 将数据级别划分为“可公开”、“仅限内部”、“绝密/机密”3~4个等级。明确将绝密及以上级别的源代码、客户个人信息、未发布的财务报表列为禁止输入AI的对象。
- 规范仅使用许可的官方渠道: 通过公司规章限制使用个人ChatGPT账号,同时统合官方渠道,要求使用公司层面签约的ChatGPT Enterprise或内部专属AI平台。
- 制定安全违规时的报告与应对流程: 设立可立即通知安全团队的热线和自首上报程序,避免员工在发生失误时因害怕惩罚而隐瞒,从而引导迅速采取初期处置措施。
- 定期开展员工AI安全培训: 超越单纯的技术控制,按季度向员工介绍最新的泄露受害案例和正确的提示词使用方法,帮助团队成员自主提升安全意识。
 AI 生成图片
企业引入ChatGPT时,安全团队常犯的4个错误及解决方案是什么?
安全负责人经常存在一些误区。例如认为只要购买了Enterprise套餐就能一劳永逸,或者反过来无条件封禁AI访问、放任内部权限管理不顾,以及在构建RAG检索时遗漏文档访问权限等错误。为了防止这些错误,必须制定以下应对方案:
- 错误 1:“以为订阅了Enterprise方案就绝对安全”
- 解决方案: Enterprise方案仅能阻止OpenAI侧将数据用于模型再训练,并不能防止企业内部员工的滥用或外部提示词注入攻击。必须同时配置企业内部DLP解决方案并联动监控日志。
- 错误 2:因出于对威胁的恐惧而无条件全面封禁生成式AI
- 解决方案: 一味封禁会诱使员工利用个人手机热点等手段偷用AI,从而助长“影子AI”。与其盲目封禁,不如单独普及受安全管控的企业内部平台,这才是更为明智之举。
- 错误 3:共享API密钥及忽视细粒度权限管理
- 解决方案: 如果多个部门共用同一个API密钥,一旦发生事故将难以追究责任。应当按项目或部门拆分密钥,并定期审查权限。
- 错误 4:构建RAG(检索增强生成)时未联动文档访问权限(ACL)
- 解决方案: 将公司规章或文档打包到向量数据库中供AI回答时,必须联动细粒度权限控制系统,防止普通员工访问到高管专用的绩效评估或财务机密文档。
常见问题
Q. 订阅ChatGPT Enterprise或Team方案后,企业数据就绝对安全了吗?
这些方案默认提供输入数据不用于OpenAI模型再训练的政策。然而,这并不能完全防止员工无意中输入机密信息或遭受提示词注入等攻击,因此必须配合企业内部的DLP脱敏和权限管理体系才能确保安全。
Q. 使用OpenAI API开发企业内部专属应用时,输入数据会被用于训练吗?
不会。通过OpenAI API传输的数据默认遵循不用于模型训练的政策(Default Opt-Out)。在传输和存储过程中,也会应用TLS 1.2+及AES-256加密标准。
Q. 如何拦截员工使用个人账号登录ChatGPT的“影子AI”现象?
在网络端通过CASB和安全代理控制个人账号访问或未经批准的AI URL,同时由公司统一 provide 经过认证的Enterprise专属账号或内部提示词网关作为替代渠道,这样处理最为有效。
Q. 什么是提示词注入(Prompt Injection)攻击?该如何预防?
提示词注入是指在AI输入框中注入恶意的指令语句,从而绕过AI原本的设定规则并窃取企业内部数据的攻击方式。可以通过引入输入输出校验过滤器,并在网关层面上进行持续的安全异常监测来进行预防。